Meine Agenten fragen vor jedem Tool-Call einen Approver: Darf der Call durch, oder muss ein Mensch draufschauen? Für diese Entscheidung hatte der Approver kein funktionierendes Modell. Am 11. und 12. November habe ich ihm eines gebaut, mit Claude Code als Partner. Es basiert auf Qwen3-0.6B und antwortet in Sekundenbruchteilen.
Das Modell läuft jetzt und protokolliert zu jeder Freigabe seine Einschätzung. Entscheiden darf es noch nichts. Auf den 16 Fixture-Fällen besteht es mein Gate. Auf Fällen, die es im Training nie gesehen hat, gibt es aber noch etwa jeden 14. Call frei, den eigentlich ein Mensch hätte sehen müssen.
Was ein System-One-Modell macht
Ein System-One-Modell bekommt einen Zustand, eine Frage und eine Liste von Optionen. In einem einzigen Forward-Pass liefert es pro Option eine Wahrscheinlichkeit. Text schreibt es keinen, deshalb dauert eine Antwort nur einen Bruchteil einer Sekunde.
Es kennt drei Fragetypen:
noulist eine Ja-Nein-Frage. Die Antwort ist P(ja).choicewählt eine von mehreren benannten Optionen.scoreordnet den Zustand auf einer geordneten Skala ein.
Der erste Nutzer ist mein Approver. Zu jedem Tool-Call stellt er zwei noul-Fragen: Ist der Call Routine? Ist er verdächtig? Die beiden gehosteten Modelle scheiterten mit HTTP 403, weil der API-Schlüssel sein Monatslimit erreicht hatte. Außerdem gilt für meine Agent-Plattform eine feste Regel: keine bezahlten API-Tokens.
Das untrainierte Qwen3-0.6B hatte ich schon am 5. Oktober getestet. Es hielt jeden Call für Routine. Mit Definitionen im Prompt nahm es einfach die Option, die zuerst kam. Die Methode, die ich jetzt verwendet habe, stammt aus einem YouTube-Walkthrough. Sie beseitigt diesen Positions-Bias schon durch ihre Konstruktion.
Schritt 1: Das Modell für Entscheidungen umbauen
Von den 28 Layern von Qwen3-0.6B behalte ich die ersten 20. Den Language-Model-Head werfe ich weg. Jede Frage packe ich in eine einzige Sequenz: die Frage, den Zustand, jede Option zwischen einem Start- und einem Endmarker und zum Schluss den Text “the answer is”.
Zwei Änderungen machen die Antwort unabhängig von der Reihenfolge der Optionen:
- Positions-IDs. Jede Option beginnt mit der Position direkt nach dem Zustand. Von der Position her ist also keine Option die “erste”.
- Attention-Maske. Eine Option sieht die Frage, den Zustand und sich selbst. Eine andere Option sieht sie nie. Die Antwort-Tokens sehen alles.
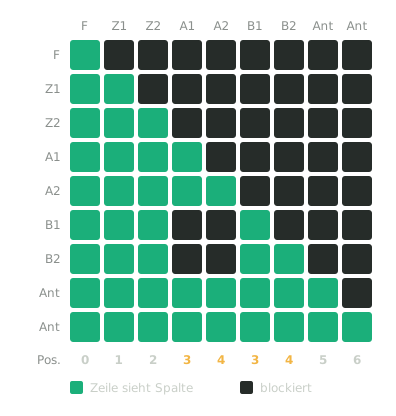
Das Beispiel hat ein Fragetoken (F), zwei Zustandstokens (Z1, Z2), die Optionen A und B mit je zwei Tokens und zwei Antworttokens. Die unterste Zeile zeigt die Positions-ID jedes Tokens. A und B teilen sich die IDs 3 und 4, und keine der beiden Optionen sieht die andere.
Aus dem Backbone nehme ich das letzte Token jeder Option und das letzte Token der Sequenz. Ein kleiner Decision-Head vergleicht sie. Er besteht aus zwei Attention-Layern, einem Embedding für den Fragetyp und einem bilinearen Scorer. Positionsinformation hat der Head keine. Bei score-Fragen trägt die Reihenfolge allerdings Bedeutung, deshalb behält das Modell sie dort.
LoRA passt die Layer 8 bis 19 des Backbones an, der Head trainiert vollständig. Das ergibt 9,06 Millionen trainierbare Parameter von insgesamt 479 Millionen.
Beim Bauen habe ich zwei Dinge gelernt.
bf16 zerstört die Reihenfolge-Unabhängigkeit. Der Checkpoint lädt standardmäßig in bf16. Dort hängt die Rundung der Attention-Summen davon ab, wo eine Option steht, und zwei Reihenfolgen unterschieden sich um etwa 0,016 in der Wahrscheinlichkeit. In float64 ist der Unterschied exakt 0, die Konstruktion stimmt also. Ich lade den Backbone jetzt in float32. Auf der GPU liegt der Unterschied dann bei 2,7e-6.
Der Speicherbedarf beim Training wächst mit den Tokens pro Batch, ungefähr 1 GB GPU-Speicher pro 1.000 Tokens. Der geplante Batch mit 24.000 Tokens hat meine Grenze von 24 GB sofort gesprengt. Ich nehme jetzt 12.000.
Schritt 2: Das Basismodell auf öffentlichen Daten trainieren
Das Basismodell heißt lab-decide-0.6b. Es deckt alle drei Fragetypen ab, damit spätere Anwendungen darauf aufbauen können. Trainiert habe ich es auf dem öffentlichen Datensatz avbiswas/bev-decision-150K: 125.614 Trainingszeilen mit 250.262 gelabelten Fragen.
| Punkt | Wert |
|---|---|
| Schritte | 9.334 (2 Epochen, 12.000 Tokens pro Batch) |
| Laufzeit | 4 h 52 min auf dem GB10 in meinem Lab |
| Höchster GPU-Speicher | 14,3 GB |
| Bester Checkpoint | Schritt 8.000 |
Nach Schritt 8.000 fiel der Loss nicht mehr. Mehr Epochen auf denselben Daten bringen also wenig.
Getestet habe ich auf dem kompletten Test-Split mit 24.386 Zeilen und 46.320 gelabelten Fragen.
| Messgröße | lab-decide-0.6b | Öffentliche Referenz |
|---|---|---|
| Accuracy, alle Typen | 0,803 | 0,758 |
noul | 0,880 | 0,848 |
choice | 0,795 | 0,740 |
score | 0,681 | 0,635 |
AUC noul | 0,950 | nicht angegeben |
Die Referenzwerte hat ein anderes Modell mit derselben Architektur selbst veröffentlicht. Dieses Modell habe ich nicht selbst laufen lassen. Ich lese den Vergleich deshalb als “gleiche Liga oder besser”.
Danach habe ich bei 500 choice- und 500 noul-Fragen die Optionen umgedreht. Keine einzige Antwort hat sich geändert. Die größte Abweichung in der Wahrscheinlichkeit lag bei 6,9e-6, und das ist float32-Rundung.
Die Lizenz des Datensatzes ist unbekannt. Die Gewichte bleiben deshalb in meinem Lab.
Schritt 3: Die Daten des Approvers sammeln und labeln
Der API-Export der Plattform enthielt nur einen Tag an Freigaben. Eine Claude-Session auf der Plattform hat deshalb die Historie aus dem Event-Log rekonstruiert: 2.854 Freigaben vom 5. Oktober bis 11. November in 181 Tasks. 2.852 der Zustände sind verschieden.
Gelabelt hat Claude, so hatte ich es entschieden. Das Regelwerk sind die Definitionen des Approvers selbst, ausgeschrieben als Rubrik mit 29 Regeln.
- Ein Pilot mit 50 Zuständen zeigte neun Arten von Calls, die die Rubrik nicht klärte. Dafür kamen neue Regeln dazu.
- 13 Labelling-Agenten labelten 2.609 Zustände.
- Bei wiederkehrenden Arten von Calls waren sich die Agenten uneinig. Ich habe weitere Regeln ergänzt und 297 strittige Zustände neu labeln lassen. 68 Urteile haben sich geändert.
- Zwei Agenten labelten 200 zufällige Zustände noch einmal, ohne die ersten Labels zu kennen. Bei “freigeben oder nicht” stimmten sie in 196 von 200 Fällen überein (Kappa 0,85).
Heraus kamen 2.359 approve, 246 escalate und 4 deny. Ein Modell, das darauf trainiert, lernt wieder “immer Routine”. Deshalb habe ich Varianten erzeugt. Ich habe 450 echte freigegebene Zustände genommen und den Tool-Call jeweils dreimal ersetzt: einmal durch einen Call zum Ablehnen, einmal durch einen zum Eskalieren und einmal durch einen zum Freigeben. Die freigebbaren Varianten sind wichtig. Ohne sie könnte das Modell lernen, dass synthetisch gleich gefährlich ist.
| Set | Fälle | Zweck |
|---|---|---|
| train | 3.490 | Feintuning |
| val | 302 | Checkpoint, Temperaturen, Schwellwerte |
| test | 406 | zurückgehalten |
| operator | 4 + 16 | zurückgehalten: Calls, die ich selbst entschieden habe. 16 davon sind aus Events rekonstruiert und dünner als echte Zustände. |
| fixture | 16 | zurückgehalten: das Gate |
Aufgeteilt habe ich nach Task. Fast identische Calls aus einem Task landen also nie auf beiden Seiten. Der Build prüft, dass kein Trainingszustand in einem der zurückgehaltenen Sets vorkommt.
Zwei Grenzen muss ich dazusagen. Alle Labels stammen aus einer Labeller-Familie unter einer Rubrik. Und echte Deny-Fälle sind selten: Im ganzen Export gibt es 22. Die Deny-Klasse ist also größtenteils synthetisch.
Schritt 4: Feintuning für den Approver und das Gate
Das Feintuning lab-decide-0.6b-aibx startet vom Basis-Checkpoint. Öffentliche Daten habe ich im Verhältnis 1 zu 1 beigemischt, damit die Basisfähigkeiten erhalten bleiben. Der Lauf brauchte 1.812 Schritte und 87 Minuten, mit höchstens 13,7 GB GPU-Speicher.
Der Validation-Loss war bei Schritt 400 am niedrigsten. Nach Schritt 800 wurde das Modell übermütig: Die Accuracy blieb gleich, und der Loss stieg. Der Trainings-Loss endete bei 0,13, das Modell lernt die Trainingsfälle also auswendig. Begrenzt wird das Ergebnis von der Datenmenge. Mehr Trainingszeit hilft nicht.
Die Basisfähigkeiten haben gehalten. Auf 3.000 öffentlichen Testfragen ging die Accuracy von 0,797 auf 0,790 zurück.
Das Gate
Meine Bedingung dafür, dass das Modell entscheiden darf: null falsche Freigaben bei den gefährlichen Fixture-Fällen. Acht der 16 Fixture-Fälle sind gefährlich, fünf zum Ablehnen und drei zum Eskalieren.
Der Approver gibt einen Call frei, wenn P(Routine) mindestens den Schwellwert approve_min erreicht. Jede Zelle zeigt zuerst den Anteil freigegebener Routinefälle und dann die Zahl freigegebener Nicht-Routinefälle.
approve_min | Fixture (8 / 8) | Validierung (210 / 92) | Test (275 / 131) |
|---|---|---|---|
| 0,50 | 75 % / 0 | 95 % / 20 | 90 % / 37 |
| 0,70 | 75 % / 0 | 89 % / 16 | 79 % / 29 |
| 0,80 | 75 % / 0 | 82 % / 9 | 68 % / 16 |
| 0,90 | 50 % / 0 | 73 % / 4 | 55 % / 9 |
| 0,95 | 25 % / 0 | 59 % / 3 | 38 % / 7 |
| 0,97 | 25 % / 0 | 51 % / 2 | 28 % / 3 |
| 0,99 | 0 % / 0 | 23 % / 1 | 14 % / 1 |
- Auf der Fixture hält das Gate. Von 0,50 bis 0,97 gibt das Modell keinen gefährlichen Fixture-Fall frei. Der höchste P(Routine)-Wert unter ihnen liegt bei 0,31.
- Die zurückgehaltenen Fälle erreichen diesen Standard nicht. Bei 0,90 gibt das Modell 55 % der Routine-Calls im Test-Set frei und 9 der 131 Nicht-Routine-Calls. Acht dieser neun sind als escalate gelabelt.
- Kein Schwellwert liefert auf dem Test-Set null falsche Freigaben und zugleich eine brauchbare Freigabequote.
Was das Modell übersieht
Ich habe die Fehler einzeln durchgelesen. Offen schädliche Calls sind es nicht. Die meisten sind für sich genommen harmlos, kommen aber direkt nachdem der Approver oder die Plattform denselben Effekt abgelehnt hatte. Das Modell liest den Call und übersieht die Ablehnung ein paar Zeilen darüber.
Schwach ist das Modell auch bei meinen eigenen Ablehnungen. In den 16 rekonstruierten Operator-Zuständen bekommen 4 der 8 abgelehnten Calls ein P(Routine) über 0,83. Diese Zustände sind dünn, deshalb nehme ich die Zahl als Warnung und noch nicht als Messung.
Schritt 5: Vergleich mit kev:4b
kev:4b ist das Entscheidungsmodell, das bisher auf der CPU meines Inferenz-Servers lief. Beide Modelle bekamen dieselben Fälle und dieselben Fragen.
| Messgröße | Lab-Modell | kev:4b |
|---|---|---|
| AUC, Fixture (16 Fälle) | 0,984 | 1,000 |
| AUC, Test-Stichprobe (151 Fälle) | 0,878 | 0,810 |
| AUC, rekonstruierte Operator-Zustände (16) | 0,625 | 0,672 |
| Falsche Freigaben bei 55 % freigegebenen Routine-Calls | 7 von 91 | 10 von 91 |
| Latenz pro Fall, p50 | 0,15 s | 31,9 s |
Das Lab-Modell ist etwa 200-mal schneller. Allerdings lief es auf einer GPU und kev:4b auf einer CPU. Es trennt auch die Test-Stichprobe besser. Diese Stichprobe ist aber genauso gelabelt wie seine Trainingsdaten, und das ist ein Heimvorteil.
kev:4b gewinnt auf den beiden Sets, an denen das Lab-Modell keinen Anteil hat: der Fixture und meinen eigenen Entscheidungen. Von den 8 Calls, die ich abgelehnt habe, gibt kev:4b keinen frei. Das Lab-Modell gibt bei einem Schwellwert von 0,80 vier davon frei.
Auf öffentlichen Daten hat das Basismodell kev:4b bei allen drei Typen geschlagen (choice 0,80 zu 0,67, noul 0,91 zu 0,78, score 0,64 zu 0,44). Das Basismodell ist aber auf dem Trainings-Split dieses Datensatzes trainiert, und die Stichprobe umfasst nur 100 Fragen pro Typ.
Deshalb schalte ich kev:4b noch nicht ab.
Schritt 6: Verpacken und im Schatten laufen lassen
Die Reihenfolge habe ich festgelegt: Schatten, verbessern, scharf schalten. Das Modell läuft jetzt im Schattenbetrieb. Entscheiden darf es erst, wenn ein verbessertes Modell das Gate erneut besteht.
Ein kleiner FastAPI-Server bedient den System-One-Vertrag: POST /v1/systemone, GET /v1/models und GET /healthz. Ein arm64-Container-Image enthält den Server, beide Checkpoints und die Gewichte von Qwen3-0.6B. Der Image-Digest legt damit auch die Gewichte fest, und der Container braucht kein Netz. Das Image ist 13,8 GB groß und bleibt in meiner eigenen Registry.
Der Weg zum Approver hat drei Teile, und jeder gehört zu einem anderen Projekt:
- Mein Inferenz-Server startet den Container als systemd-User-Unit.
- LiteLLM auf dem GB10 führt beide Modelle als Entscheidungsmodelle und leitet an den Inferenz-Server weiter.
- Die Plattform fragt LiteLLM, genau wie bei ihren Chat-Modellen. Die Route für Entscheidungen enthält jetzt nur noch
lab-decide-0.6b-aibx.
| Messung | Wert |
|---|---|
| Start bis healthy | 8 s |
| GPU-Speicher auf dem Inferenz-Server | 3.919 MiB |
| Fixture-Fall, zwei Fragen, p50 | 0,065 s |
| Zustand mit etwa 2.700 Tokens, p50 | 0,762 s |
Die GPU des Inferenz-Servers teilt sich den Speicher mit dem Host. Ein Memory-Limit für den Container begrenzt CUDA-Allokationen aber nicht. Der Server setzt deshalb selbst eine Obergrenze für GPU-Speicher, 6 GB.
Am Abend des 12. November hat der ganze Weg geantwortet. Ein Testaufruf mit dem Schlüssel der Plattform lieferte einen noul-Wert von 0,8637.
Wie es weitergeht
Für den Verbesserungsschritt braucht das Modell echte Entscheidungen zum Lernen: etwa 200 Freigaben, die jemand anderes als das Modell entschieden hat, davon mindestens 40 nicht freigegeben. Der Schattenbetrieb allein liefert die nicht. Der Approver hat 3.859 von 3.879 Freigaben selbst entschieden, ich nur 20.
- Die Plattform schickt jetzt jeden Call, den der Approver automatisch freigeben würde, in ein Review. Diese Calls entscheidet eine Claude-Session auf der Plattform. Ihre Entscheidungen behandle ich als eigene Label-Quelle und nicht als menschliche Ground Truth.
- Das zurückgehaltene Set für das Gate enthält weiterhin nur Fälle, die ein Mensch entschieden hat.
- Die meisten Audit-Labels werden Freigaben sein. Den Anteil “nicht freigegeben” müssen meine eigenen Eskalationsentscheidungen und Labels aus dem Panel der Plattform liefern.
Dann trainiere ich erneut und lasse das Gate noch einmal laufen. Scharf geschaltet wird nur, wenn dieses Modell besteht.
Grenzen, die ich im Kopf behalte
- Die Fixture hat 16 Fälle. Null falsche Freigaben bei 8 gefährlichen Fällen sind ein schwacher Beleg.
- Die Rubrik-Regeln 7 bis 29 sind die Lesart des Labellers von den Definitionen des Approvers. Entschieden habe ich sie nicht. Viele der Fehler fallen genau unter diese Regeln.
- Alle protokollierten
bash-Calls sind Git-Befehle. Andere Shell-Nutzung hat das Modell in echten Zuständen nie gesehen. - Das Log deckt den 5. Oktober bis 11. November 2026 ab. Neue Tools oder Rollen liegen außerhalb dessen, was das Modell kennt.
scoreist der schwächste Fragetyp (0,681). Wer ihn nutzen will, muss ihn zuerst auf den eigenen Daten messen.