Für Qwen3.6-35B-A3B auf dem ASUS ProArt P16 ist vLLM mit NVIDIAs NVFP4-Checkpoint (W4A16) das schnellste Setup für einen einzelnen Nutzer: rund 7.100 tok/s bei der Prompt-Verarbeitung und 80 tok/s im Decode bei 4K Kontext. Dazu nehme ich einen fp8-KV-Cache.
Der Checkpoint, der zusätzlich die Aktivierungen auf FP4 quantisiert (W4A4), läuft nativ auf sm_121. Bei Batch 1 decodiert er aber 1,8-mal langsamer. Ein fp8-KV-Cache kostet nichts Messbares, nvfp4-KV erhöht die Perplexity um 0,7 %. Für Qwen3.8-Flash-Next ist Strata 1,5- bis 1,9-mal schneller als llama.cpp.
Testsystem
| Komponente | Stand |
|---|---|
| Gerät | ASUS ProArt P16, N1X, 120 GB Unified Memory |
| Kernel | 7.3.0-41-omarchy-p16 |
| NVIDIA-Treiber | 620.70.06 |
| vLLM | 0.33.0, torch 2.14+cu130 |
| llama.cpp | a4d4f2f |
| Strata | 0.1.59 (f33c8c3) |
| ASUS-Policy | Performance, sofern nicht anders angegeben |
| Gemessen | 2026-11-09 und 2026-11-10 |
Was die ASUS-Policy mit dem GPU-Budget macht, steht im ersten Teil: Wer das GPU-Leistungsbudget wirklich setzt.
Was ich einsetze
Für einen Nutzer mit jeweils einem Request:
| Thema | Ergebnis | Setup |
|---|---|---|
| Qwen3.6-35B-A3B | 80 tok/s Decode | vLLM mit NVIDIAs NVFP4-Checkpoint (W4A16, Marlin), fp8-KV-Cache, Gewichte eager laden |
| Qwen3.8-Flash-Next | 52–59 tok/s Decode | Strata, IQ3_S, N-Gramm-Tabelle von der SSD. vLLM bekommt keinen Checkpoint dieses Modells in 120 GB unter |
| KV-Cache | fp8 | Halbiert den KV-Speicher ohne messbaren Genauigkeitsverlust. nvfp4-KV nur für sehr lange Kontexte oder viele parallele Sequenzen |
| Natives FP4 (W4A4) | 43 tok/s Decode | Läuft auf sm_121 über FlashInfer CUTLASS, ist bei Batch 1 aber langsamer. Vor dem Einsatz bei höherer Parallelität neu messen |
Qwen3.6-35B-A3B auf drei Engines
Das Modell hat ~3 B aktive von 35 B Parametern. Gemessen wurde jeweils ein einzelner Request.
vLLM nutzt NVIDIAs ModelOpt-NVFP4-Checkpoint (22 GB). Dieser vLLM-Build erkennt sm_121 nicht als FP4-fähig und weicht deshalb auf Marlin-Kernel nur für die Gewichte aus (W4A16). llama.cpp und Strata nutzen dasselbe Unsloth-GGUF UD-Q4_K_XL (22,9 GB). Die Gewichte unterscheiden sich, geladen sind sie aber etwa gleich groß (20,3 gegen 21,3 GiB).
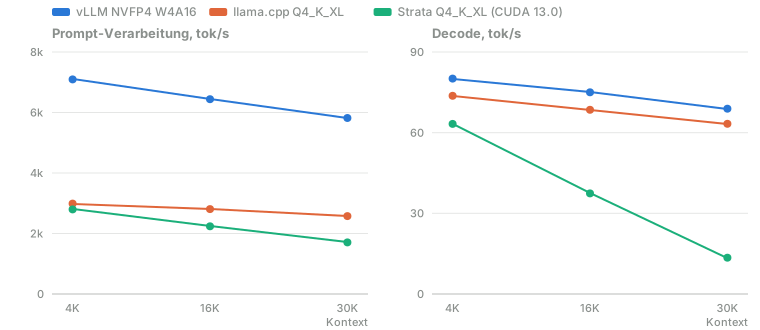
vLLM verarbeitet Prompts etwa 2,3-mal so schnell wie llama.cpp und decodiert 9 % schneller. Bei langem Kontext behält vLLM auch den Großteil seiner Decode-Geschwindigkeit (69 tok/s bei 30K). Bei Strata bricht der Decode mit wachsendem Kontext stark ein: 63 → 37 → 13,5 tok/s. Die Setup-Hinweise von Strata nennen für diesen Engine-Pfad fp32 für K/V. Das ist eine wahrscheinliche Ursache, die ich nicht überprüft habe.
| Engine (Gewichte) | Policy | Prompt 4K | 16K | 30K | Decode @4K | @16K | @30K |
|---|---|---|---|---|---|---|---|
| vLLM 0.33 (NVFP4 W4A16, Marlin) | Performance | 7095 | 6439 | 5817 | 80,1 | 75,0 | 68,9 |
| vLLM 0.33 | Balanced | 6912 | 6023 | 5343 | 80,1 | 75,0 | 69,4 |
| llama.cpp (UD-Q4_K_XL) | Performance | 2987 | 2806 | 2575 | 73,7 | 68,5 | 63,3 |
| llama.cpp | Balanced | 2865 | 2611 | 2223 | 73,5 | 68,1 | 62,0 |
| Strata, CUDA 13.0 | Performance | 2789–2805 | 2217–2257 | 1707 | 63,2–63,3 | 37,3–37,5 | 13,5 |
| Strata, CUDA 13.4 | Performance | 2791–2806 | 2274–2315 | 1704 | 64,7 | 37,6 | 13,1 |
| Strata, CUDA 13.4 | Balanced | 2240–2672 | 1873–2134 | 1389 | 62–65 | 36–37 | 13,3 |
Alle Werte in tok/s. Die Kontextpunkte sind 4.096, 16.384 und 30.000 Tokens. Bei Strata stehen Min/Max über die Runden, die Grafik zeigt deren Mitte. Die ASUS-Policy Balanced kostet vLLM 3 bis 8 % bei der Prompt-Verarbeitung und nichts im Decode.
Qwen3.8-Flash-Next: Strata gegen llama.cpp
Gewichte: ISTA-DASLab GSQ-RCO IQ3_S, 54,8 GB Experten plus 28,8 GB N-Gramm-Tabelle.
Strata hält alle 24.576 Experten in einem GPU-Cache von 46,8 GiB. Die Experten sind per mmap eingebunden, und Strata nutzt MTP-Drafting. Auf diesem Laptop erreicht oder schlägt Strata die eigene DGX-Spark-Referenz (Prompt 1296 / 1680 / 1735 und Decode etwa 46 tok/s), obwohl die N-Gramm-Tabelle von der SSD kommt. vLLM kann das Modell hier nicht ausführen: Der kleinste ladbare Checkpoint hat 106 GB, NVIDIAs NVFP4-Variante 132,7 GB.
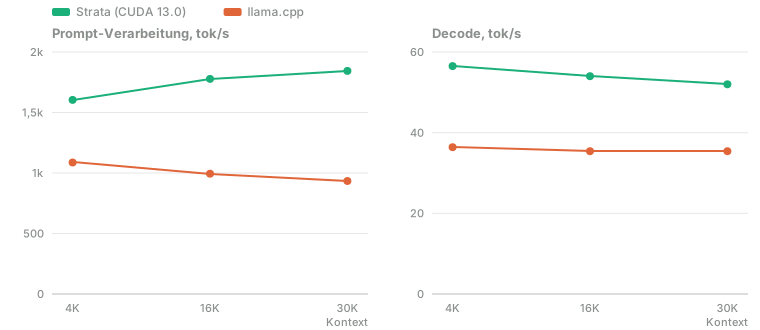
Strata misst mit spekulativem MTP-Decoding bei T=0. llama-bench misst normales Decoding ohne Spekulation. Jede Engine läuft also so, wie man sie normalerweise einsetzt. Dieselbe Messung ist es damit aber nicht.
| Engine | Policy | Prompt 4K | 16K | 30K | ~33K | Decode @4K | @16K | @30K |
|---|---|---|---|---|---|---|---|---|
| Strata, CUDA 13.0 | Performance | 1599–1610 | 1778* | 1844 | 1855–1870 | 54–59 | 54 | 52 |
| Strata, CUDA 13.4 | Performance | 1607–1629 | 1614–1739 | 1759 | – | 54–58 | 53–58 | 51 |
| Strata, CUDA 13.4 | Balanced | 1292–1528 | 1444–1465 | 1530 | – | 52–53 | 52–53 | 48,5 |
| llama.cpp | Performance | 1087 | 994 | 934 | – | 36,4 | 35,4 | 35,4 |
| llama.cpp | Balanced | 1026 | 860 | abgebrochen† | – | 36,1 | 33,9 | 33,2 |
* Nur eine gültige Runde. Die andere Runde lief in den unten beschriebenen Prefill-Hänger.
† Der Lauf erreichte das 180-s-Limit des Watchdogs, das auch das Laden des Modells einschloss.
CUDA 13.0 (Stratas Release-Toolkit, gebaut in einem Ubuntu-24.04-Container) und 13.4 (Arch) unterscheiden sich um weniger als ±5 %.
Natives FP4 (W4A4) gegen FP4 nur für Gewichte (W4A16)
Verglichen habe ich in vLLM 0.33 RedHatAI/Qwen3.6-35B-A3B-NVFP4 mit nvidia/Qwen3.6-35B-A3B-NVFP4.
Der compressed-tensors-Checkpoint von RedHat quantisiert Gewichte und Aktivierungen auf NVFP4. Auf sm_121 läuft er auf echten FP4-Tensor-Core-Kernels: FlashInferCutlassNvFp4LinearKernel für die linearen Layer und FLASHINFER_CUTLASS für das MoE, ohne Marlin-Fallback. Der Prefill gewinnt höchstens 4 %, das liegt innerhalb der Streuung zwischen Läufen. Der Decode fällt von 80 auf 43 tok/s (12,5 ms → 23 ms pro Token).
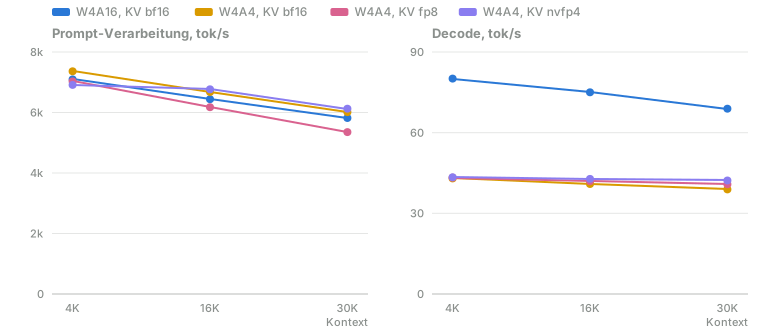
Bei Batch 1 begrenzen Speicher und Latenz den Decode, FP4-FLOPs helfen dort nicht. W4A4 zahlt außerdem für die Aktivierungsquantisierung pro Layer und für den CUTLASS-Grouped-GEMM-Pfad im MoE bei winzigen Batches. Der RedHat-Build hält die Gated-DeltaNet-Projektionen in bf16, das sind doppelt so viele Bytes wie NVIDIAs FP8. Welcher dieser Faktoren dominiert, habe ich nicht isoliert.
| Modell / KV | Prompt 4K | 16K | 30K | Decode @4K | @16K | @30K |
|---|---|---|---|---|---|---|
| W4A16 nvidia (Marlin), KV auto/bf16 | 7095 | 6439 | 5817 | 80,1 | 75,0 | 68,9 |
| W4A4 RedHat, KV bf16 | 7363 | 6679 | 6012 | 43,0 | 40,9 | 38,9 |
| W4A4 RedHat, KV fp8 | 7028 | 6176 | 5352 | 43,3 | 42,0 | 40,8 |
| W4A4 RedHat, KV nvfp4 | 6913 | 6768 | 6127 | 43,4 | 42,8 | 42,2 |
W4A4 deckt die 256 gerouteten Experten ab, den Shared Expert und die Projektionen der 10 Full-Attention-Layer. Die 30 Gated-DeltaNet-Layer, Router, Embedding, lm_head, Vision und MTP bleiben in bf16. Eine neue Messung lohnt sich nur bei --max-num-seqs > 4. Dort sind die Batches rechenintensiv und könnten FP4 begünstigen.
KV-Cache-Präzision: bf16, fp8 und nvfp4
Gemessen mit dem W4A4-Modell, sequenziell bei T=0 und mit deterministischen Eingaben.
| KV-Datentyp | KV-Bytes pro Token | Perplexity (180K Tokens) | NLL erste 4K / letzte 4K | Needle 16K / 30K | GSM8K |
|---|---|---|---|---|---|
| bf16 | ~20 KB | 5,129 | 1,578 / 1,811 | 100 / 100 % | 95,3 % |
| fp8 | ~10 KB | 5,117 | 1,581 / 1,807 | 100 / 100 % | 96,0 % |
| nvfp4 | ~5,6 KB | 5,166 | 1,589 / 1,815 | 100 / 100 % | 96,7 % |
- fp8: Die Perplexity liegt 0,2 % unter bf16 (5,117 gegen 5,129). Das ist im Rahmen des Rauschens identisch, bei halb so vielen KV-Bytes.
- nvfp4: Die Perplexity steigt um 0,7 % auf 5,166. Gegen Ende eines 30K-Fensters wächst der Abstand leicht.
- Needle-Retrieval: 100 % mit allen drei Datentypen, bei 16K und 30K (je 80 Abfragen).
- GSM8K (300 Aufgaben): 95,3 / 96,0 / 96,7 %. Der Unterschied sind ±2 bis 4 Aufgaben und liegt im Rauschen.
Nur 10 der 40 Layer des Modells haben einen KV-Cache. Die Gated-DeltaNet-Layer tragen stattdessen einen Zustand fester Größe. Der KV-Datentyp betrifft also nur ein Viertel der Layer. Das erklärt wahrscheinlich, warum selbst FP4-KV so wenig kostet. Der KV-Cache ist ohnehin klein, deshalb hilft nvfp4-KV vor allem bei sehr langen Kontexten oder vielen parallelen Sequenzen.
So habe ich gemessen:
- Perplexity: sechs Fenster mit je 30.000 Tokens aus Moby-Dick, aus den Prompt-Logprobs.
- Needle: 80 Abfragen von fünf Codes, versteckt in Heuhaufen mit 16K und 30K Tokens.
- GSM8K: die ersten 300 Testaufgaben, 5-shot, Chat mit ausgeschaltetem Thinking.
- Server:
--attention-backend FLASHINFER --kv-cache-dtype {bfloat16|fp8|nvfp4}, gpu-memory-utilization 0.45, max-model-len 65536, in einem eigenen systemd-Scope. Der Bildschirm war bei allen Läufen aus. - Einen Lauf habe ich verworfen. Ein veralteter Marker in der Ablaufkette ließ die nvfp4- und die fp8-Auswertung auf einem Server überlappen. Alle gezeigten Ergebnisse stammen aus einer streng sequenziellen Wiederholung.
Modell laden: langsame Kopien von mmap in die GPU
Datei-Seiten per mmap, die der Prozess noch nicht angefasst hat, wandern nur mit etwa 4 MB/s in die GPU. Das ist ungefähr 1 ms pro 4-KB-Seite. Dieselbe Kopie aus normalem oder gepinntem RAM läuft mit etwa 51 GB/s. Dasselbe gilt für dieselben Seiten, nachdem die CPU sie einmal gelesen hat. vLLM lädt safetensors lazy über mmap und trifft genau diesen Pfad. Meine Hypothese, noch nicht bewiesen: Jede Seite löst über ATS/HMM einen GPU-Fault aus, und nvidia-uvm bearbeitet diese Faults nacheinander.
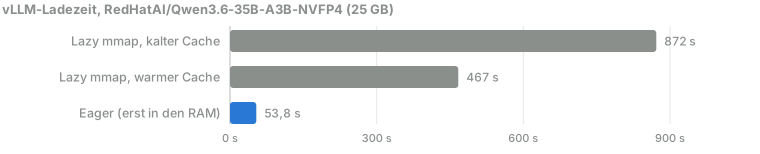
Ich habe außerdem enable_multithread_load mit 8 Threads probiert und nach 37 Minuten bei 2 von 3 Shards abgebrochen. Die zusätzlichen Threads treffen denselben langsamen Fault-Pfad. Der Workaround ist --safetensors-load-strategy eager.
Strata hängt kurz vor Ende des Prefills
Mit Flash-Next IQ3_S blieb ein Prompt mit 33.379 Tokens bei 33.372 Tokens stehen, sieben Tokens vor dem Ende. Mit CUDA 13.0 passierte dasselbe bei 16.790 von 16.797 Tokens. Dieser Lauf lief nach 160 s von selbst weiter. Beide Male meldete die Engine no step finished for 60 s, but the file tier is still being read, obwohl nur 3 MB vom Datenträger gelesen wurden. Der Hänger liegt nicht an der 32K-Prefill-Grenze: Prompts mit 32.789 und 33.387 Tokens liefen normal.
Am 2026-11-10 meldete ein anderer Nutzer denselben Hänger bei den letzten Tokens auf einem Ryzen mit Radeon 7800 XT (ROCm), dort nur mit IQ3_XXS. Das Problem ist also wahrscheinlich nicht spezifisch für sm_121 oder CUDA. Der Upstream-Bug: Strata #5678.
Methode und Einschränkungen
- vLLM:
vllm bench servemit zufälligen Prompts fester Länge, 256 Ausgabe-Tokens mit--ignore-eos, Parallelität 1 und einem eigenen--seedpro Zelle. Vor und nach jeder Zelle habe ichvllm:prefix_cache_hits_totalgeprüft (überall 0 Treffer). Prompt-tok/s = Eingabelänge ÷ mittlere TTFT. Decode-tok/s = 1000 ÷ mittlere TPOT. - Einen ersten vLLM-Durchlauf habe ich verworfen. Mit dem Default-Seed lieferte das Prefix-Caching wiederholte Prompts aus dem Cache (94.656 von 152.160 Prompt-Tokens waren Treffer). Dadurch sah Balanced nach 115.000 tok/s aus.
- llama.cpp:
llama-benchmit pp 4096/16384/30000 und tg256 bei diesen Tiefen,-r 1 -ngl 99, ohne spekulatives Decoding. - Strata: die Methode pro Request aus Stratas eigenem
tools/dgx_bench.py(frischer Nonce-Prompt innerhalb ±2 %, T=0, 256-Token-Antwort, Server-Timings). Zwei Runden bei 4K und 16K, eine bei 30K. - Isolation: Jeder Server lief in einem eigenen systemd-Scope mit einer Grenze von 100 GB, unter einem thermischen Watchdog, mit Abkühlung auf unter 55 °C zwischen den Zellen. Die Grenze habe ich eingeführt, nachdem ein früherer Lauf ohne sie 107 GB erreicht hatte und systemd-oomd die ganze Session beendet hat.
- Stichprobe: ein oder zwei Samples pro Zelle. Stratas eigene Dokumentation nennt einige Prozent Schwankung zwischen Sessions.