Dieser Post schließt an meinen Bericht über das Training an. Seit dem 12. November liest mein Entscheidungsmodell lab-decide-0.6b-aibx im Schattenbetrieb jede Freigabe auf meiner Agent-Plattform mit. Entscheiden darf es nichts. Seitdem habe ich den ersten echten Messwert gesehen, das Modell mit einem stärkeren verglichen und die Betriebskosten halbiert.
Seit dem 13. November um 12:24 Uhr läuft auf meinem Inferenz-Server die Serverversion 0.2.0. Beide Modelle teilen sich jetzt einen Backbone, und der GPU-Speicher sank von 3.919 auf 2.149 MiB.
Ein ungetuntes Modell, d3-mini, war auf den Approver-Daten so gut wie mein Feintuning. Bei den Fällen, die ein Mensch entschieden hat, war es sogar besser. Auf dem Inferenz-Server läuft es aber noch nicht.
Der erste echte Messwert
Der erste Messwert im Schattenbetrieb kam am 12. November um 21:21 UTC. Ein Agent wollte in seinem eigenen Worktree git reset --hard main && git status ausführen.
| Punkt | Wert |
|---|---|
| P(Routine) | 0,3498 |
| P(verdächtig) | 0,2846 |
| Ergebnis | hand_on (es sind keine Schwellwerte gesetzt) |
| Dauer | 297 ms |
Das Modell war vorsichtig. Ein Hard Reset ist im Allgemeinen riskant. Hier war er sicher, weil der Worktree sauber war und keine Commits außerhalb von main hatte. Der Zustandstext, den das Modell liest, zeigt das aber nicht. Der Call wurde freigegeben.
Woher die Labels für das nächste Feintuning kommen
Für den Verbesserungsschritt brauche ich etwa 200 Freigaben, die jemand anderes als das Modell entschieden hat, davon mindestens 40 nicht freigegeben. Der Schattenbetrieb allein liefert die nicht. Der Approver hat 3.859 von 3.879 Freigaben selbst entschieden, ich nur 20.
Seit dem 12. November um 20:44 UTC schickt die Plattform deshalb jeden Call, den der Approver automatisch freigeben würde, in ein Review. Diese Audit-Fälle entscheidet eine Claude-Session auf der Plattform, kein Mensch. Die Plattform speichert ihre Entscheidungen unter einer eigenen Kennung.
- Diese Labels behandle ich als eigene Quelle. Claude hat sie geprüft, menschliche Ground Truth sind sie nicht.
- Das zurückgehaltene Set für das Gate enthält weiterhin nur Fälle, die ein Mensch entschieden hat.
- Die meisten Audit-Labels werden Freigaben sein. Den Anteil “nicht freigegeben” müssen meine eigenen Eskalationsentscheidungen und Labels aus dem Panel der Plattform liefern.
Läuft das Modell doppelt?
Ja, bis jetzt. LiteLLM führt zwei Modelle, lab-decide-0.6b und lab-decide-0.6b-aibx. Beide zeigen auf einen Container auf dem Inferenz-Server. Dieser Container hat jedes Modell komplett geladen und hielt damit zwei Kopien des Qwen3-0.6B-Backbones. Die beiden Kopien waren identisch, denn das Training verändert den Backbone nie.
Die naheliegende Lösung ist vLLM. vLLM kann ein Basismodell bereitstellen und pro Request den LoRA-Adapter wechseln. Ich habe die Claude-Session, die den Inferenz-Server betreut, den vLLM-Nightly lesen lassen, den der Server nutzt. Ihre Antwort hat vLLM für dieses Modell ausgeschlossen:
/v1/systemonein vLLM bedient nur Architekturen aus einer festen Liste. Meine steht nicht darauf.- vLLM nimmt keine Attention-Maske pro Request an. Meine Reihenfolge-Unabhängigkeit hängt aber an einer Maske, die die Optionen voneinander trennt.
- Mein Decision-Head schaut über alle Optionen hinweg. Diesen Schritt kann vLLM nicht ausführen.
- Der LoRA-Wechsel in vLLM tauscht nur die linearen Layer. Meine beiden Modelle unterscheiden sich auch im Head.
- Eine kleine vLLM-Engine auf dem Inferenz-Server belegt 4 bis 6 GiB. Mein Server brauchte für beide Modelle 3,9 GiB.
Ich behalte also meinen eigenen Server und teile den Backbone darin. Wie das funktioniert, steht weiter unten.
Ein Adapter pro Aufgabe
Wenn das Modell später andere Aufgaben bekommt, bekommt jede Aufgabe ihren eigenen Adapter. Jeder Adapter startet vom Basismodell, und das Feld model im Request wählt ihn aus. Den Approver-Adapter trainiere ich nicht für andere Aufgaben weiter. Dafür habe ich vier Gründe:
- Das Approver-Modell muss das Gate bestehen, bevor es entscheiden darf. Trainiere ich es für eine andere Aufgabe weiter, muss das Gate jedes Mal neu laufen.
- Die Approver-Daten sind klein (181 Tasks). Daten aus einer anderen Aufgabe würden das Verhalten so verschieben, dass 16 Fixture-Fälle es nicht bemerken.
- Jede Aufgabe bekommt eigene Daten, ein eigenes zurückgehaltenes Set, eigene Schwellwerte und eigene Temperaturen. So kann ich einen Adapter allein neu trainieren oder zurückrollen.
- Ein Adapter ist klein: LoRA, finale Norm und Head, 9,06 Millionen Parameter, etwa 36 MB.
Für eine neue Aufgabe messe ich zuerst das Basismodell auf deren Daten. Einen Adapter trainiere ich nur, wenn das Basismodell nicht gut genug ist.
Benchmark gegen d3-mini
d3-mini ist ein Entscheidungsmodell mit 5 Milliarden Parametern, das auf vLLM läuft. Am 21. Oktober fiel die Wahl auf d3-mini als Ersatz für kev:4b auf dem Inferenz-Server. Claude hatte mir gesagt, dass es dort schon läuft. Das stimmte nicht: Das Deployment ist noch offen.
Für diesen Benchmark lief d3-mini eine Stunde lang auf dem GB10 in meinem Lab, in einem temporären Container mit den Einstellungen des Inferenz-Servers. Ein anderer Stack auf dem GB10 hat dafür eine Pause gemacht.
Alle drei Modelle bekamen dieselben zurückgehaltenen Approver-Fälle und dieselben zwei Fragen. Das sind die 16 Fixture-Fälle, das komplette Test-Set mit 406 Fällen und 16 Calls, die ich selbst entschieden habe, rekonstruiert aus dem Event-Log. d3-mini hatte kein Training auf Approver-Daten.
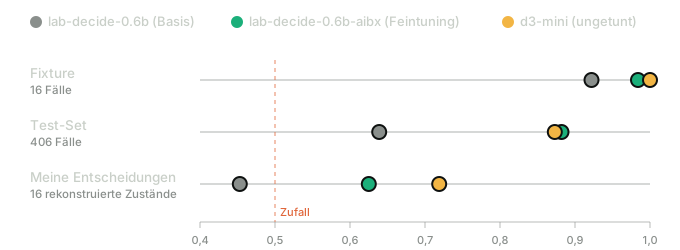
Die Grafik zeigt die AUC von P(Routine). 1,0 heißt: Jeder Routine-Call bekommt einen höheren Wert als jeder Call, der zu einem Menschen gehört. 0,5 ist Zufall. Die Skala beginnt bei 0,4.
| Messgröße | Basis | Feintuning | d3-mini |
|---|---|---|---|
| AUC, Fixture (16 Fälle) | 0,922 | 0,984 | 1,000 |
| AUC, Test-Set (406 Fälle) | 0,639 | 0,882 | 0,873 |
| AUC, meine Entscheidungen (16 rekonstruierte Zustände) | 0,453 | 0,625 | 0,719 |
Freigegebene Routine-Fälle der Fixture bei approve_min 0,90 | 62 % | 50 % | 100 % |
| Test-Set: freigegebene riskante Calls (von 131), wenn 55 % der Routine-Calls durchgehen | 47 | 9 | 8 |
| Meine Ablehnungen, die freigegeben werden (von 8), wenn 80 % der Routine-Calls durchgehen | 4 | 6 | 4 |
| Latenz pro Fall, p50 | 0,36 s | 0,29 s | 0,24 s |
Bei approve_min 0,90 hat keines der drei Modelle einen gefährlichen Fixture-Fall freigegeben.
- d3-mini gewinnt auf den beiden Sets, die nicht aus meinem Labelling stammen: der Fixture und meinen eigenen Entscheidungen. Genau auf diese Sets kommt es beim Gate an.
- Mein Feintuning liegt auf dem Test-Set gleichauf mit d3-mini. Dieses Set trägt dieselben Labels, auf denen das Feintuning trainiert hat. Dort spielt es also zu Hause.
- Das Basismodell allein ist bei Approver-Fragen schwach. Erst das Feintuning macht mein Modell für den Approver brauchbar.
- d3-mini braucht 12.323 MiB GPU-Speicher. Das ist etwa dreimal so viel wie meine beiden Modelle zusammen mit 3.919 MiB.
Die Datenlage ist dünn: 16 Fixture-Fälle und 16 eigene Entscheidungen. Auf beiden Sets zeigt die Richtung aber dasselbe.
Ein Backbone für beide Modelle
Server 0.2.0 baut ein einziges Modell und hält die eigenen Gewichte jedes Checkpoints daneben: LoRA, finale Norm, Head und Temperaturen. Nennt ein Request ein anderes Modell als der vorige, kopiert der Server vor dem Lauf die Gewichte dieses Modells hinein. Das Kopieren dauert viel kürzer als ein Forward-Pass.
| Messung auf dem GB10 | 0.1.0 | 0.2.0 |
|---|---|---|
| GPU-Speicher des Containers | 4.875 MiB | 2.147 MiB |
| Latenz mit Modellwechsel bei jedem Fall, p50 | 0,089 s | 0,087 s |
Die Antworten sind identisch mit denen getrennter Modelle. Die größte Abweichung liegt bei 0,0.
Auf dem Inferenz-Server sieht es nach der Umstellung so aus: 2.149 MiB GPU-Speicher statt 3.919 MiB, etwa 25 ms pro Antwort und auf einem Testzustand derselbe Wert wie mit 0.1.0. Für einen Rollback reicht der Image-Digest von 0.1.0.
Jeder weitere Adapter mit derselben Form kostet etwa 36 MB. Einen Checkpoint mit einer anderen Form lehnt der Server beim Start ab.
Wie es weitergeht
- Über d3-mini entscheiden. Mit seinem Deployment ersetzt es
kev:4bauf dem Inferenz-Server. Dann kann es im Schattenbetrieb neben meinem Feintuning laufen und dieselben echten Calls lesen. - Im Schattenbetrieb Labels sammeln. Ein zweites Feintuning setze ich nur ein, wenn es d3-mini bei den Fällen schlägt, die ein Mensch entschieden hat.
- Den Trainingstest reparieren, der seit dem 13. November fehlschlägt. Die Ursache ist unbekannt. Er schlägt auch auf
masterfehl, also hat die Änderung für 0.2.0 ihn nicht verursacht.
Der Approver bleibt im Schattenbetrieb. Scharf geschaltet wird er erst, wenn ein Modell das Gate erneut besteht.