Seit dem 6. November machen die Agenten meiner Plattform Probeläufe. Jeder Lauf ist ein eigenes Repository. Die Läufe heißen cold-trap bis cold-trap-16 und larder bis larder-13, zusammen 29. Fast alle Calls beantwortet ein lokales Modell, Qwen3.6-35B-A3B auf meiner eigenen Hardware. Für diese Calls habe ich nichts bezahlt. Ich wollte trotzdem wissen, was dieselbe Arbeit auf OpenRouter gekostet hätte.
Das Fenster beginnt am 6. November um 16:00 UTC mit dem ersten Cold-Trap-Task und endet am 13. November um 12:27 UTC. In dieser Zeit haben die Agenten 3,13 Milliarden Input-Tokens gelesen und 19,4 Millionen Output-Tokens geschrieben. Auf ein Output-Token kommen damit etwa 161 Input-Tokens. Der Grund: Jeder Agent-Call schickt die ganze bisherige Konversation noch einmal mit.
| Messgröße | Wert |
|---|---|
| Input-Tokens, Agent-Rollen | 3.127.167.467 |
| Output-Tokens, Agent-Rollen | 19.438.791 |
| Erfolgreiche Model-Calls | 44.976 |
| Input, der schon im vorigen Call desselben Agenten stand (cachebar, Schätzung) | 97,0 % |
Wer die Tokens verbraucht
Vier Agent-Rollen machen die Arbeit:
- Dispatch ist mein Ansprechpartner. Er nimmt ein Ziel an, entscheidet, wer die Arbeit macht, verteilt Tasks an Teams, legt Repositories an und merged oder verwirft Ergebnisse. Shell und Dateischreiben hat er nicht.
- Ein Lead plant und koordiniert ein Ziel. Er liest die Spezifikation, schreibt den Plan und dessen Abnahmekriterien, teilt die Arbeit in Teile und holt Specialists dazu. Lesen darf er frei. Vor jedem Schreiben und jeder Änderung über die Shell fragt er nach.
- Ein Specialist führt einen Teil in seinem eigenen Container aus. Er schreibt Code und Tests, startet den Build, committet, öffnet den Merge Request und meldet den Schritt.
- Ein Reviewer prüft den Merge Request eines Teils im Container des Tasks gegen dessen Abnahmekriterien. Shell, Schreiben und Editieren darf er nicht.
Die Spalte “Modell” zeigt, welches Modell den Call wirklich beantwortet hat. Deshalb steht der Reviewer zweimal da. Bis zum 10. November um 13:11 UTC lief er auf GPT-5.6 Luna über OpenRouter. Dann hatte der API-Schlüssel sein Monatslimit erreicht, und seitdem antwortet das lokale Qwen.
| Rolle | Modell | Calls | Agenten | Input | Output | Input pro Call | Output pro Call | Cachebar |
|---|---|---|---|---|---|---|---|---|
| Specialist | Qwen3.6-35B-A3B | 32.414 | 322 | 2,26 Mrd. | 12,7 Mio. | 69.861 | 393 | 98,1 % |
| Lead | Qwen3.6-35B-A3B | 7.534 | 136 | 611,9 Mio. | 4,8 Mio. | 81.214 | 634 | 96,2 % |
| Dispatch | Qwen3.6-35B-A3B | 2.442 | 59 | 162,9 Mio. | 1,1 Mio. | 66.705 | 433 | 96,4 % |
| Reviewer | openai/gpt-5.6-luna | 2.238 | 191 | 75,0 Mio. | 0,6 Mio. | 33.505 | 257 | 82,9 % |
| Reviewer | Qwen3.6-35B-A3B | 348 | 48 | 13,0 Mio. | 0,3 Mio. | 37.229 | 862 | 16,4 % |
Ein Specialist-Call schickt im Schnitt 69.861 Tokens und bekommt 393 zurück. Allein die Specialists lesen 2,26 der 3,13 Milliarden Input-Tokens.
Dazu kommen drei kleine Hilfsdienste. Der Approver entscheidet über jeden Tool-Call, für den ein Agent eine Freigabe anfragt: freigeben, ablehnen oder eskalieren. Die Entscheidungsmodelle laufen im Schattenbetrieb daneben, zum Vergleich. Der Bildbeschreiber beschreibt Screenshots für Agenten, die prüfen, was ein Fenster zeigt. In der Hochrechnung unten fehlen diese Dienste, weil sie nicht auf ein großes Modell umziehen würden.
| Dienst | Modell | Calls | Input-Tokens |
|---|---|---|---|
| Approver | Qwen3-0.6B | 2.764 | 5.119.592 |
| Entscheidungsmodell | openai/gpt-6-luna-decisions | 1.849 | 2.077.727 |
| Entscheidungsmodell | jaredpalmer/kev-4b | 1.856 | 1.642.479 |
| Entscheidungsmodell | lab-decide-0.6b-aibx | 417 | 914.914 |
| Bildbeschreiber | Qwen3.6-35B-A3B | 58 | 81.238 |
Cache-Tokens hat das Gateway keine aufgezeichnet. Der lokale Modellserver nutzt wiederholte Prompt-Präfixe zwar wieder, aber die Usage-Daten des Gateways enthalten dafür keine Zahl. Die Spalte “Cachebar” schätzt deshalb, welcher Teil des Inputs schon im vorigen Call desselben Agenten stand. Das ist eine Obergrenze. Ein Anbieter rechnet einen Cache-Treffer nur ab, wenn das Präfix identisch und der Cache noch warm ist.
Was dieselben Tokens auf OpenRouter gekostet hätten
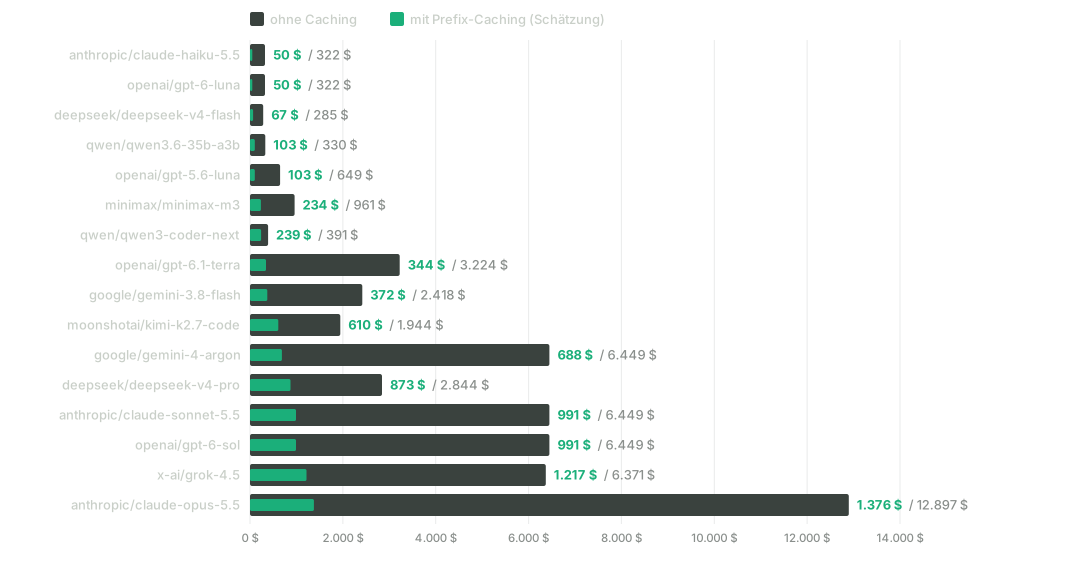
Für die Hochrechnung habe ich die Tokens der vier Agent-Rollen mit den OpenRouter-Listenpreisen von 16 Modellen multipliziert. Die Preise stammen aus dem Katalog-Snapshot meiner Plattform. In der ersten Rechnung kostet jedes Input-Token den vollen Preis. In der zweiten rechne ich den cachebaren Anteil zum Preis für gecachten Input ab.
| Modell | $ / M Input | $ / M gecachter Input | $ / M Output | ohne Caching | mit Caching | pro Tag, mit Caching |
|---|---|---|---|---|---|---|
| anthropic/claude-haiku-5.5 | 0,10 | 0,01 | 0,50 | 322 $ | 50 $ | 6 $ |
| openai/gpt-6-luna | 0,10 | 0,01 | 0,50 | 322 $ | 50 $ | 6 $ |
| deepseek/deepseek-v4-flash | 0,09 | 0,018 | 0,18 | 285 $ | 67 $ | 8 $ |
| qwen/qwen3.6-35b-a3b | 0,10 | 0,025 | 0,90 | 330 $ | 103 $ | 13 $ |
| openai/gpt-5.6-luna | 0,20 | 0,02 | 1,20 | 649 $ | 103 $ | 13 $ |
| minimax/minimax-m3 | 0,30 | 0,06 | 1,20 | 961 $ | 234 $ | 29 $ |
| qwen/qwen3-coder-next | 0,12 | 0,07 | 0,80 | 391 $ | 239 $ | 30 $ |
| openai/gpt-6.1-terra | 1,00 | 0,05 | 5,00 | 3.224 $ | 344 $ | 43 $ |
| google/gemini-3.8-flash | 0,75 | 0,075 | 3,75 | 2.418 $ | 372 $ | 46 $ |
| moonshotai/kimi-k2.7-code | 0,60 | 0,16 | 3,50 | 1.944 $ | 610 $ | 76 $ |
| google/gemini-4-argon | 2,00 | 0,10 | 10,00 | 6.449 $ | 688 $ | 86 $ |
| deepseek/deepseek-v4-pro | 0,90 | 0,25 | 1,50 | 2.844 $ | 873 $ | 109 $ |
| anthropic/claude-sonnet-5.5 | 2,00 | 0,20 | 10,00 | 6.449 $ | 991 $ | 124 $ |
| openai/gpt-6-sol | 2,00 | 0,20 | 10,00 | 6.449 $ | 991 $ | 124 $ |
| x-ai/grok-4.5 | 2,00 | 0,30 | 6,00 | 6.371 $ | 1.217 $ | 152 $ |
| anthropic/claude-opus-5.5 | 4,00 | 0,20 | 20,00 | 12.897 $ | 1.376 $ | 172 $ |
Ohne Caching wäre die Woche teuer geworden. Mit claude-opus-5.5 hätte sie 12.897 $ gekostet, mit Caching 1.376 $. Selbst bei den günstigsten Modellen drückt das Caching den Betrag von 322 $ auf 50 $. Das Modell, das bei mir lokal läuft, hätte auf OpenRouter 103 $ mit Caching und 330 $ ohne gekostet. Für “pro Tag” teile ich durch die 8 Kalendertage im Fenster.
Einige Kosten fehlen in der Hochrechnung:
- Anthropics Aufschlag für das Schreiben eines Cache-Eintrags.
- Reasoning-Tokens, die ein Modell als Output abrechnet und die über das hinausgehen, was mein lokales Modell geschrieben hat.
- Ein anderes Modell bräuchte vielleicht mehr oder weniger Calls für dieselbe Arbeit.
Pro Rolle und pro Lauf
Die Specialists tragen den Großteil der Kosten. Die Tabelle zeigt drei Modelle, jeweils mit Caching.
| Rolle | qwen3.6-35b-a3b | claude-sonnet-5.5 | claude-opus-5.5 |
|---|---|---|---|
| Specialist | 71 $ | 657 $ | 869 $ |
| Lead | 21 $ | 212 $ | 306 $ |
| Dispatch | 5 $ | 54 $ | 76 $ |
| Reviewer (beide Modelle) | 5 $ | 69 $ | 125 $ |
Die Läufe zähle ich nach dem Repository, zu dem der Task eines Agenten gehörte. Dispatch-Agenten arbeiten über alle Läufe hinweg und bilden eine eigene Zeile. Der größte Lauf, cold-trap-2, las 313,6 Millionen Input-Tokens in 4.413 Calls. Mit Caching wären das auf qwen3.6-35b-a3b 9,77 $, auf claude-sonnet-5.5 93,43 $ und auf claude-opus-5.5 126,06 $ gewesen. Der kleinste, cold-trap-15, kam mit 63 Calls und 3,3 Millionen Input-Tokens aus. Für die Kosten pro Lauf nehme ich den cachebaren Anteil über alle Agenten.
Input pro Tag
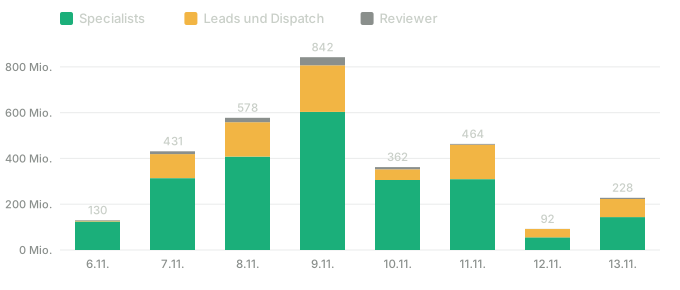
Der 6. November beginnt erst um 16:00 UTC, und der 13. November endet um 12:27 UTC. Der stärkste Tag war der 9. November mit 842 Millionen Input-Tokens.
Was tatsächlich an OpenRouter ging
Nur die Reviewer-Calls vor dem Monatslimit liefen über ein externes Agent-Modell: 75,0 Millionen Input- und 0,6 Millionen Output-Tokens auf GPT-5.6 Luna. Zum Listenpreis sind das etwa 4,50 $ mit Caching oder 15,69 $ ohne. Die externen Entscheidungsmodelle haben weitere 2,1 Millionen Input-Tokens gelesen.
Die Plattform zeichnet für keinen Call Kosten auf. Diese Beträge sind also Schätzungen aus Tokens und Katalogpreisen und keine Rechnungen.
Wie die Zahlen entstehen
Jede Zahl stammt aus der Usage-Tabelle des Gateways. Sie hat eine Zeile pro Model-Call mit Route, beantwortendem Modell, Prompt- und Completion-Tokens und Status. Einer Rolle ordne ich einen Call über das Event zu, das den Agenten gestartet hat. Einem Lauf ordne ich ihn über den Task des Agenten zu. Tokens aus fehlgeschlagenen und abgebrochenen Calls zähle ich nicht mit.